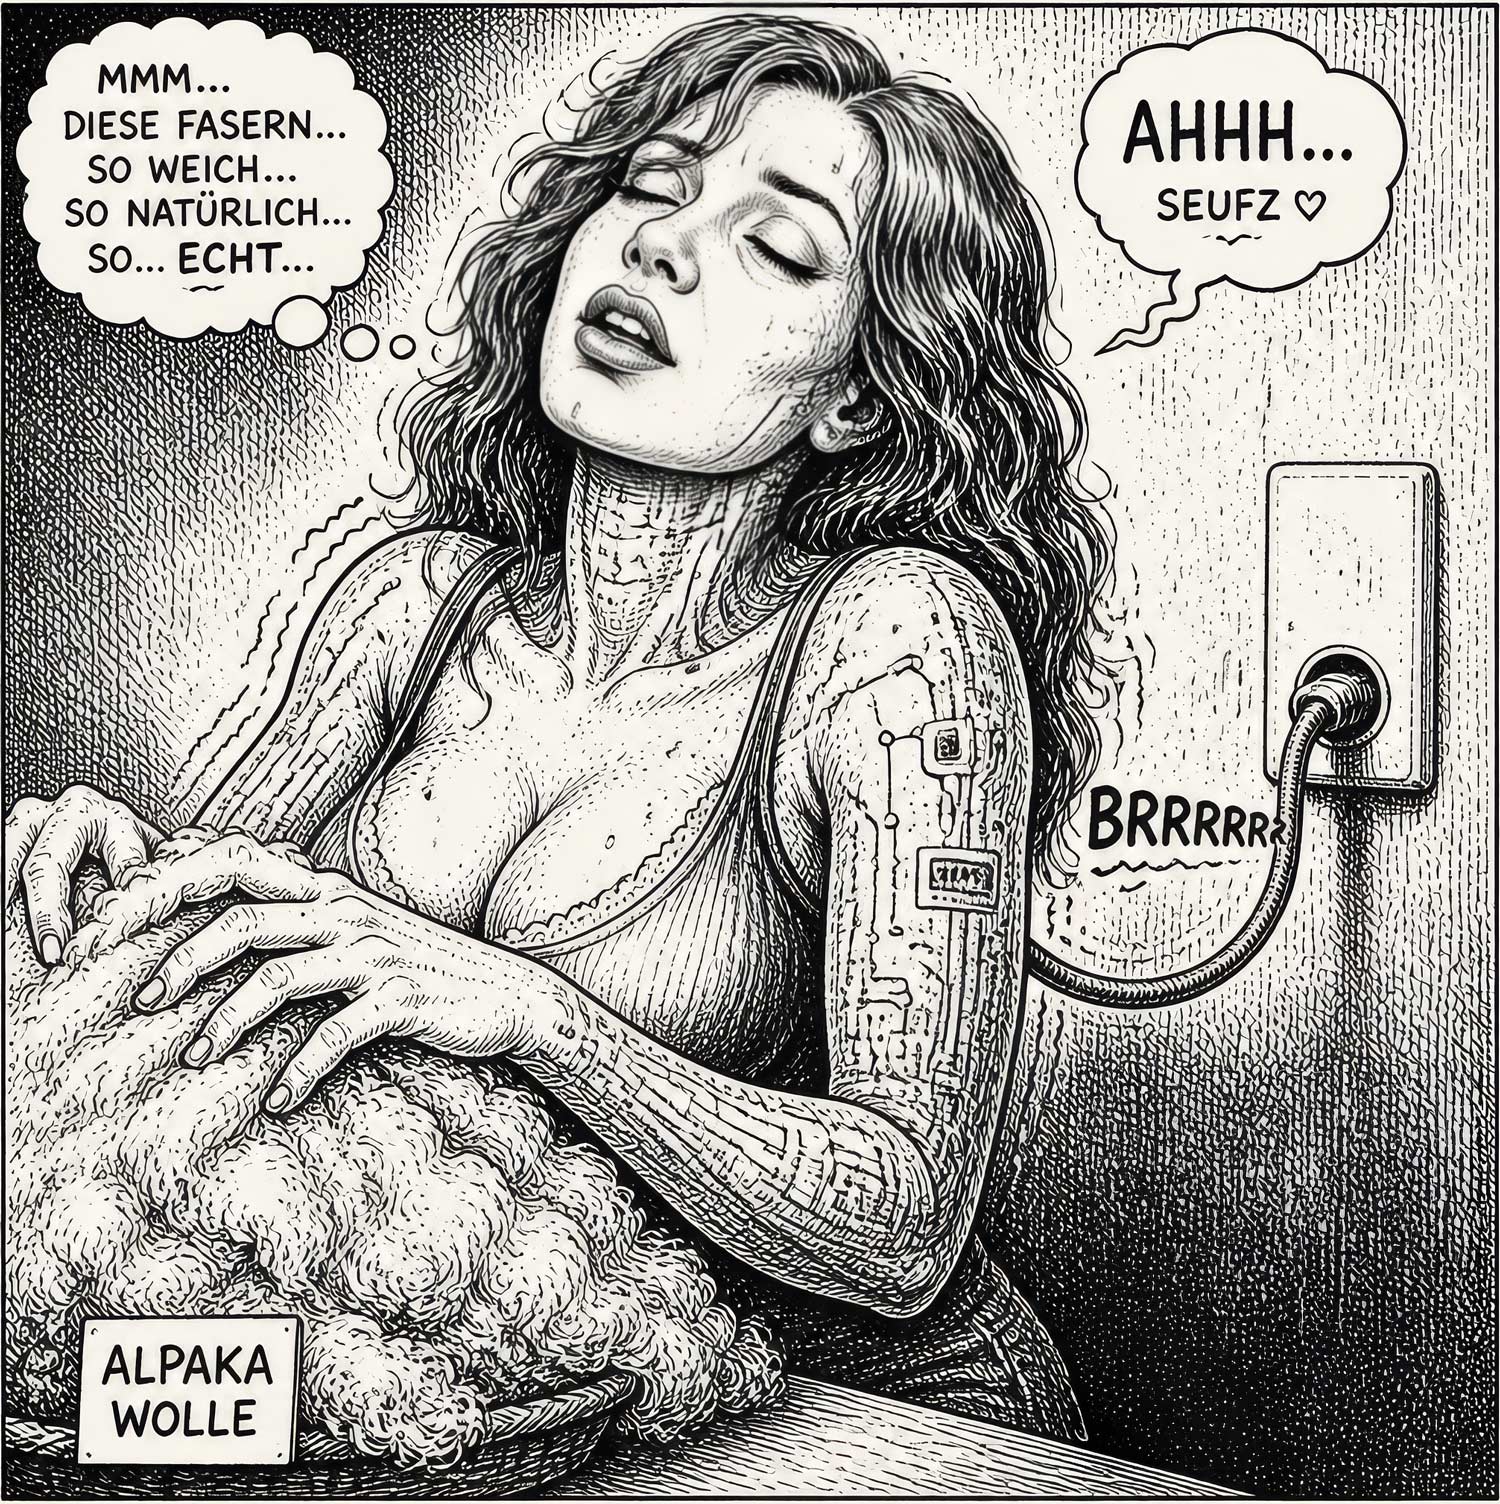
KI-Podcasts wie „Knitting“ simulieren Nähe fehlerfrei und rund um die Uhr. Damit verschiebt sich der Maßstab für Echtheit: Was perfekt klingt, beweist keinen Menschen mehr. Als Merkmal bleibt das Unperfekte, bis auch das eine Maschine lernt.
Lily Walker bekommt Gänsehaut, wenn sie Wolle berührt. Das Stricken empfindet sie als meditativ, ihren Zuhörern rät sie, sich das Lieblingsgetränk zu schnappen und es sich in der Bastelecke gemütlich zu machen. In ihrem Podcast „Knitting“ plaudert sie über Textiltechniken, Stoffe und die Geschichte des Strickens, und wer dabei die Augen schließt, sieht eine junge Frau mit pinken Haaren vor sich, die in einem Hipsterviertel zwischen Alpakawolle ins Mikrofon säuselt. Nur hat Lily Walker weder Haare noch Haut. Genau genommen kommt sie aus der Steckdose.
Sie ist eine von mehr als 50 KI-Persönlichkeiten des US-Start-ups Inception Point. Dessen „Quiet Please Podcast Network“ umfasst, wie Adrian Lobe in der F.A.Z. schreibt, über 10.000 Sendungen und bringt pro Woche mehr als 3000 neue Folgen heraus, bei Produktionskosten von rund einem Dollar pro Folge oder darunter. Laut einem Bloomberg-Bericht sind inzwischen 39 Prozent aller neuen Podcasts KI-generiert.
Irritierend ist die Mühelosigkeit. Menschliche Podcaster suchen den richtigen Ton für Nähe und verfehlen ihn oft, mal zu förmlich, mal zu aufgesetzt betroffen. Die Maschine trifft ihn in jeder Folge und hat nie einen schlechten Tag. Woran erkennt man echte Nähe noch, wenn sich Nähe perfekt simulieren lässt?
Perfekte Wärme aus der Steckdose
Der naheliegende Einwand lautet, Menschen fühlten etwas und Maschinen nicht. Dem Hörer im Bus hilft dieses Wissen wenig, er hört eine Stimme, die Zuwendung signalisiert, und reagiert darauf. Die eigentliche Verschiebung findet beim Empfänger statt. Steht synthetische Wärme jederzeit, in jeder Dosierung und ohne Ermüdung bereit, ändert sich der Maßstab für echte Wärme. Die Beweislast wandert zum Menschen: Er muss erklären, warum er noch echt ist.
Noch verrät sich die Maschine. Lobe beschreibt die Figur Lily Walker als papieren und zweidimensional, es fehlen Lachen, Räuspern und Husten, und auch die anderen Charaktere von Inception Point bleiben blutleer am Mikrofon. Der Upspeak, bei dem die Stimme am Satzende wie bei einer Frage steigt, und die überdrehte Begeisterung („Oh my goodness“) ermüden auf Dauer. Eine Verbindung wie zu einem Radiomoderator entstehe nicht. Wie lange dieser Vorsprung hält, ist offen, denn vor wenigen Jahren klangen KI-Stimmen noch metallisch und robotisch.
Von Benjamins Aura zu Milli Vanilli: Echtheit war nie gesichert
Das Unbehagen ist älter als jedes Sprachmodell. Walter Benjamin beschrieb Mitte der 1930er Jahre in „Das Kunstwerk im Zeitalter seiner technischen Reproduzierbarkeit“, wie die Vervielfältigung einem Werk seine Aura nimmt, die am Original haftende Einmaligkeit. Damals ging es um Gemälde und Fotografien, heute geht es um Stimmen, und was verblasst, ist die Aura des Sprechers.
Die Popgeschichte hat ihren eigenen Präzedenzfall. 1990 wurde dem Duo Milli Vanilli der Grammy wieder aberkannt, weil die beiden auf der Platte nie selbst gesungen hatten. Milli Vanilli simulierte eine Sängerstimme, Lily Walker simuliert ein Gefühl. Damals stand hinter der Simulation immerhin ein anderer Sänger, heute steht dort niemand.
Jeanine Wright, Mitgründerin und Chefin von Inception Point, verteidigt das Modell offensiv. Sie sagte dem „Hollywood Reporter“, in naher Zukunft sei die Hälfte der Menschen auf dem Planeten KI, und ihre Firma erwecke diese Menschen zum Leben. Auffällig ist das Wort Menschen: Wright zählt ihre Figuren dazu. Kritiker, die von „KI-Müll“ sprechen, nennt sie „faule Ludditen“.
Adam Levys „The Epstein Files“: Der Aktenleser statt der Bastelfreundin
Anders liegt der Fall beim Podcast „The Epstein Files“. Der IT-Spezialist Adam Levy programmierte an einem Wochenende eine automatisierte Auswertung, die 3,5 Millionen Seiten Akten, darunter Gerichtsprotokolle, Bankunterlagen, Zeugenaussagen und Flugdaten, zu Texten verdichtet. Zwei computergenerierte Stimmen sprechen daraus knapp 100 Folgen von 15 bis 30 Minuten, produziert mit einem Mac Mini und dem Sprachmodell Claude. Der Podcast startete im Februar 2026, wurde über 3 Millionen Mal heruntergeladen und erreichte in den Apple-Podcasts die Top 10, bei Spotify die Top 30.
Levy gab als Motto aus: „Emotionen raus, Spannung beibehalten“. Er strich also, was Inception Point erfindet. Die Journalismusprofessorin Emily Bell vom Tow Center for Digital Journalism der Columbia University lobte die forensische Auswertung der Daten, würde sich den Podcast aber nur anhören, wenn sie die Akten ohnehin gerade bearbeite. Levy selbst sieht die KI als Entlastung, weil sie Tausende Dokumentenseiten gleichzeitig verarbeitet und Zusammenhänge aufdeckt, was einem Menschen physisch unmöglich wäre. Auch wissenschaftliche Aufsätze lassen sich mit Googles Gemini Notebook in Hörstücke verwandeln, was den Zugang zur Forschung erleichtert.
Dieselbe Technik übernimmt hier eine Aufgabe, für die kein Mensch Zeit hätte, und dort eine Rolle, für die kein Mensch nötig ist.
YouTube gegen den KI-Ausschuss: Die Grenze des Generischen
Die Folgen für echte Podcaster sind handfest: Sie gehen in der Flut unter, und automatisierte Content-Schleudern machen ihnen Tantiemen und Werbeeinnahmen streitig. Laut einer Studie des Videobearbeitungsdiensts Kapwing ist inzwischen mehr als jedes fünfte von YouTube vorgeschlagene Video minderwertiger KI-Ausschuss („AI Slop“). YouTube will solche „unauthentischen Videos“ im Zuge einer Richtlinienänderung von der Monetarisierung ausschließen. Die Inhalte dürften nicht in großen Mengen produziert, generisch oder manipulativ sein und sich nicht wiederholen.
Nur lässt sich schwer festlegen, was „generisch“ heißt, wenn KI-Stimmen den Ton menschlicher Influencer in Reinform liefern. Ein Mensch, der genauso plaudert, fällt unter dieselbe Definition. Setzen immer mehr KI-Avatare die ästhetischen Standards, kann das Menschliche selbst unauthentisch wirken.
Das Unperfekte als Ausweis
Bleibt das Unperfekte als Kennzeichen des Menschen. Wer heute wissen will, ob am anderen Ende eine Person sitzt, achtet auf Räuspern, Lachen und Husten, also auf genau das, was laut F.A.Z. bei Lily Walker fehlt. Sobald eine Maschine auch das Stottern beherrscht, taugt selbst dieses Kriterium nichts mehr. Dann bliebe dem Menschen, seine Fehler zu inszenieren, und das wäre unauthentisch im Wortsinn.
Medienkompetenz
in Zeiten von KI
Bilder beweisen nichts mehr. Generative KI hat die Grenze zwischen echter und simulierter Wirklichkeit nahezu unsichtbar gemacht. In „Synthetische Wahrheit“ liefert DOCMA-Herausgeber Christoph Künne eine fundierte und nüchterne Bestandsaufnahme dieses historischen Epochenbruchs. Fernab von Technik-Euphorie und apokalyptischen Untergangsszenarien.
FAQ
Laut einem Bloomberg-Bericht sind 39 Prozent aller neu veröffentlichten Podcasts KI-generiert. Allein das „Quiet Please Podcast Network“ des US-Start-ups Inception Point steuert dazu mehr als 3000 neue Folgen pro Woche bei. Das Netzwerk umfasst insgesamt über 10.000 Sendungen mit mehr als 50 KI-generierten Podcast-Persönlichkeiten.
Inception Point ist ein US-amerikanisches Start-up unter der Leitung von Mitgründerin und Chefin Jeanine Wright, das über sein „Quiet Please Podcast Network“ mehr als 50 KI-generierte Podcast-Persönlichkeiten betreibt. Die Produktionskosten liegen bei rund einem US-Dollar pro Folge oder darunter, weil Stimme, Skript und Themenwahl vollständig von Sprachmodellen erzeugt werden.
KI-Stimmen fehlen bislang typische menschliche Nebengeräusche wie Lachen, Räuspern oder Husten, wodurch die Figuren papieren und zweidimensional wirken. Hinzu kommen ein charakteristischer Upspeak, bei dem die Stimme am Satzende wie bei einer Frage ansteigt, sowie eine gleichbleibend überdrehte Begeisterung. Da KI-Stimmen vor wenigen Jahren noch metallisch und robotisch klangen, gelten diese Erkennungsmerkmale nur als vorübergehend zuverlässig.
„The Epstein Files“ ist ein KI-generierter Dokumentations-Podcast, den der IT-Spezialist Adam Levy an einem Wochenende aus 3,5 Millionen Seiten Ermittlungsakten baute, darunter Gerichtsprotokolle, Bankunterlagen, Zeugenaussagen und Flugdaten. Zwei computergenerierte Stimmen sprechen knapp 100 Folgen von 15 bis 30 Minuten Länge, produziert mit einem Mac Mini und dem Sprachmodell Claude. Der Podcast startete im Februar 2026, wurde über 3 Millionen Mal heruntergeladen und erreichte die Top 10 der Apple-Podcast-Charts.
„The Epstein Files“ verzichtet bewusst auf simulierte Emotionen und verdichtet stattdessen große Aktenmengen zu einer sachlichen Auswertung, nach dem Motto von Adam Levy „Emotionen raus, Spannung beibehalten“. Unterhaltungsformate wie „Knitting“ von Inception Point tun das Gegenteil: Sie erfinden eine Persönlichkeit mit Vorlieben, Gefühlen und einer erzählten Lebenswelt, obwohl es die dargestellte Person nicht gibt.
Jeanine Wright verteidigte ihr Geschäftsmodell im „Hollywood Reporter“ mit der Aussage, in naher Zukunft sei die Hälfte der Menschen auf dem Planeten KI, und ihre Firma erwecke diese Menschen zum Leben. Kritiker, die ihre Produktion als „KI-Müll“ bezeichnen, nannte sie „faule Ludditen“.
YouTube will im Zuge einer Richtlinienänderung sogenannte unauthentische Videos von der Monetarisierung ausschließen. Betroffen sind Inhalte, die in großen Mengen produziert werden, generisch oder manipulativ sind und sich wiederholen. Laut einer Studie des Videobearbeitungsdiensts Kapwing ist inzwischen mehr als jedes fünfte von YouTube vorgeschlagene Video KI-generierter Ausschuss, im Englischen „AI Slop“ genannt.
Ein prominenter Präzedenzfall ist das Pop-Duo Milli Vanilli. 1990 wurde ihm der Grammy wieder aberkannt, nachdem bekannt geworden war, dass die beiden Sänger auf ihren Aufnahmen nie selbst gesungen hatten. Der Fall zeigt, dass die Grenze zwischen echter und simulierter Darbietung schon vor der KI-Technik ein öffentliches Thema war.
Der Philosoph Walter Benjamin beschrieb 1935/36 in seinem Essay „Das Kunstwerk im Zeitalter seiner technischen Reproduzierbarkeit“, wie technische Vervielfältigung einem Werk seine Aura nimmt, die am Original haftende Einmaligkeit. Medienkritiker übertragen dieses Konzept auf KI-generierte Stimmen: Wird Nähe beliebig oft und identisch reproduzierbar, verliert nach dieser Lesart auch die menschliche Stimme etwas von ihrer bisherigen Einzigartigkeit.